2022.12 — 2023.02
AI Research Engineer (인턴)
NAVER / NAVER Cloud
경기도 성남시 1784 | Document Intelligence 팀
- • 클로바노트 제목 생성 모델 개발 — Document Intelligence 팀, 약 3개월
- • DPO 등장 이전 시기, SFT + 자동 데이터 큐레이션만으로 4가지 preference 동시 개선
- • 개조식 어미·어절 수·ROUGE precision·semantic similarity 필터링 파이프라인
- • 실제 배포된 NAVER 클로바노트 'AI 요약 소제목' 기능에 기여
한양대 컴퓨터소프트웨어학부 4학년 재학 중 수행. Google ML Bootcamp 수료, CLOVA AI RUSH 1위 수상 경험이 선발 배경.
95.98%
Positive data coverage
83.71%에서 향상
-32%
어절 개수 오류율
15.5% → 10.5%
-48%
개조식 오류율
6.75% → 3.50%
-33%
ROUGE-precision 오류율
23.0% → 15.5%
제품 연결 시그널
인턴십 종료 3개월 후인 2023-05-12, 네이버 클로바 팀은 공식 블로그에서 클로바노트 'AI 요약 소제목 지원'을 공개했습니다. 인턴십 과제의 제품 방향이 외부 릴리스까지 이어졌다는 시그널입니다.
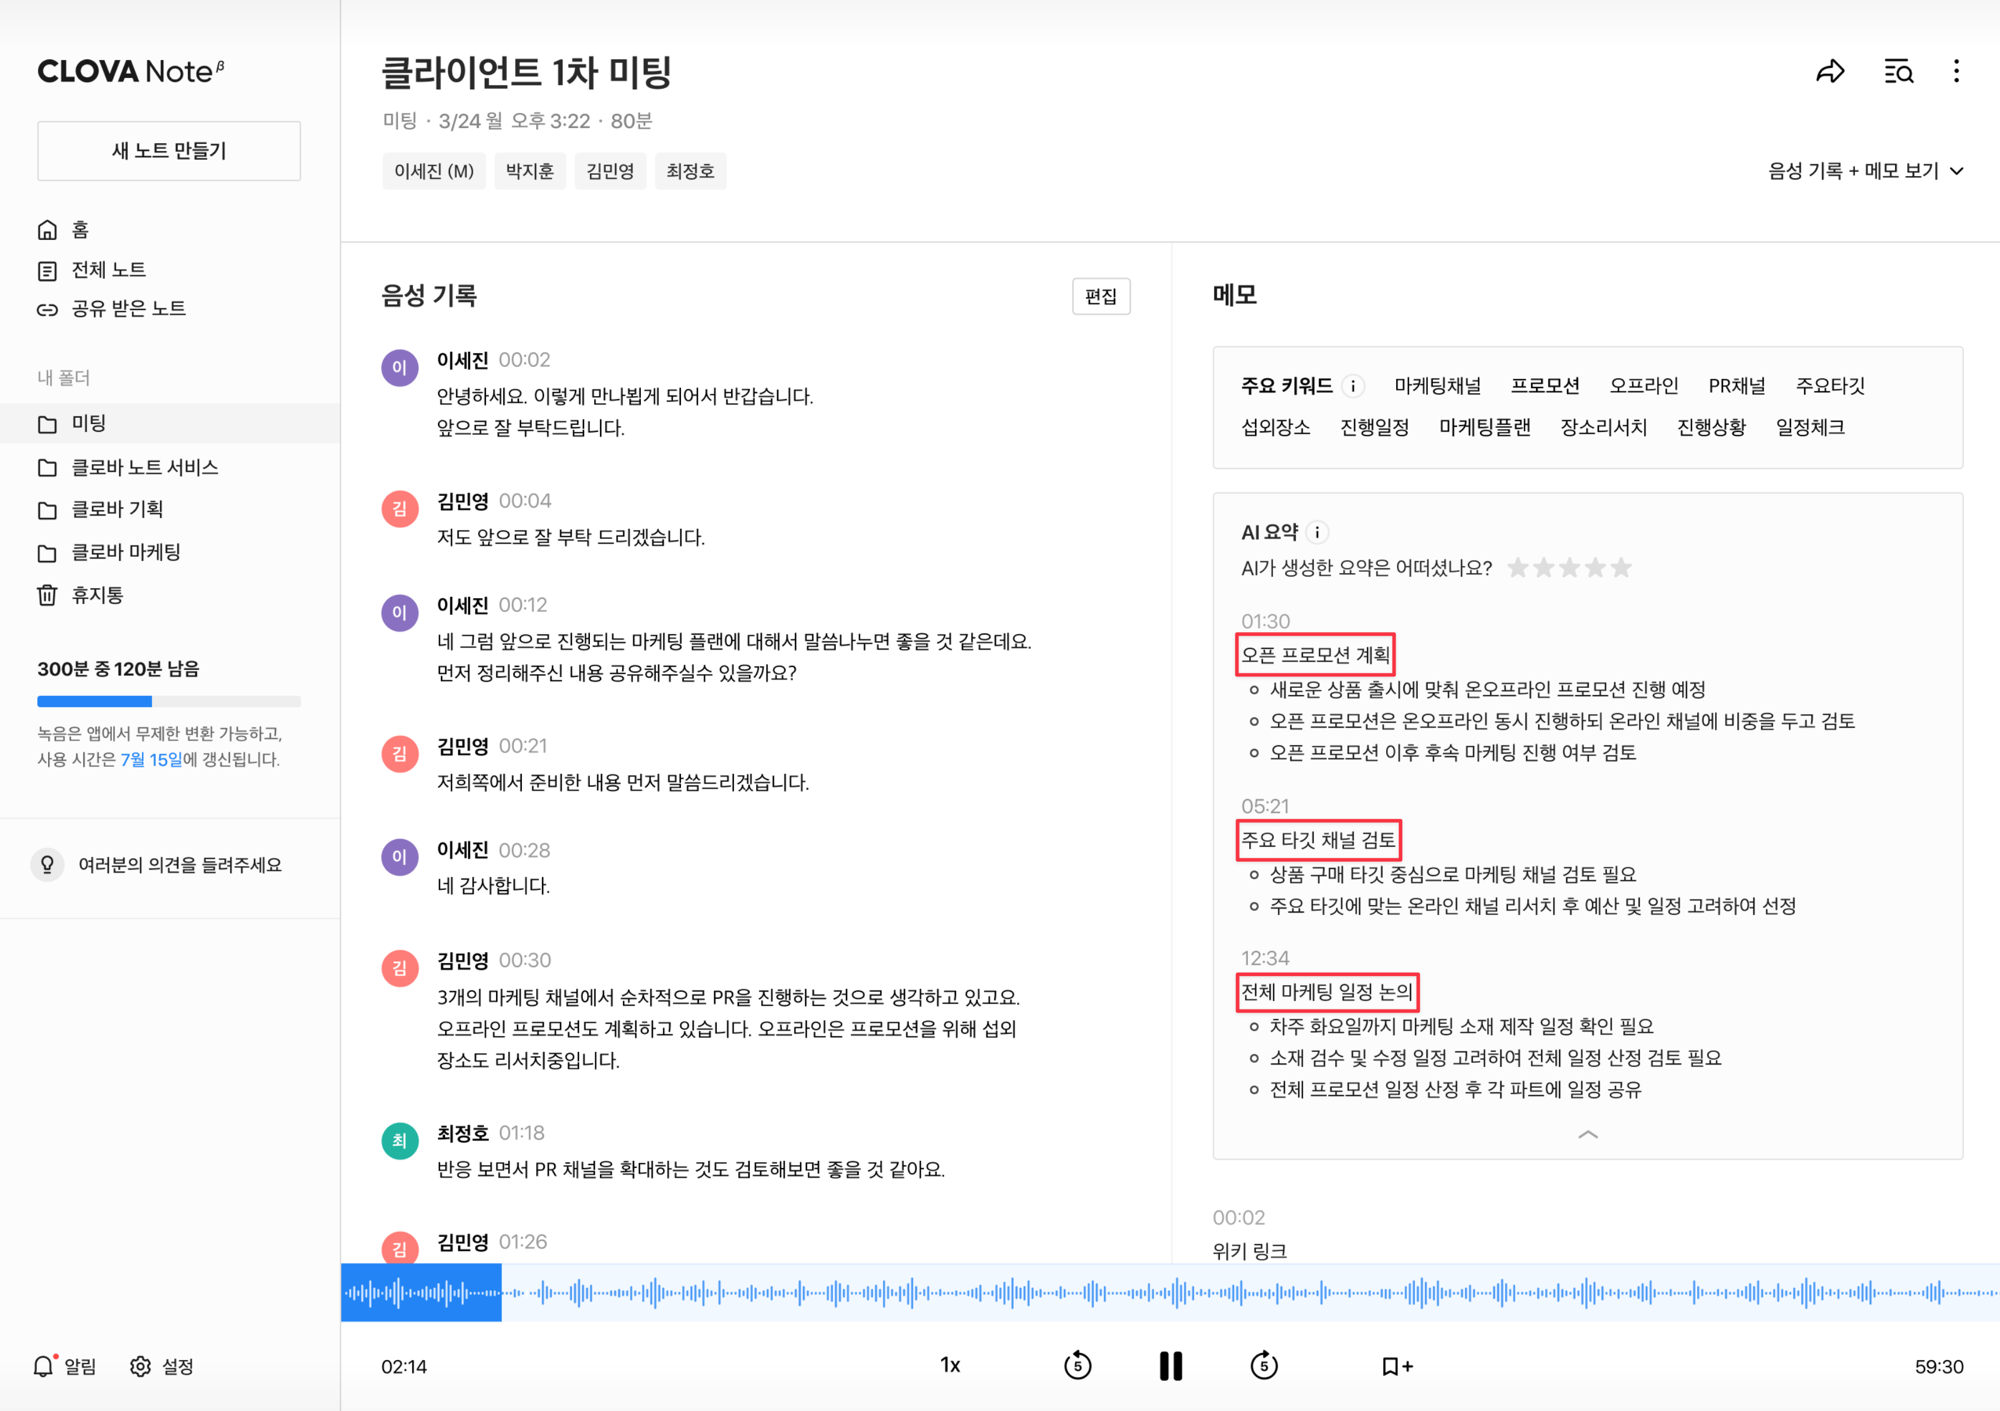
CLOVA Note — AI 요약 소제목 기능이 적용된 실제 제품 화면. 음성 기록에서 키워드 추출, 소제목 단위 요약을 제공합니다.
기술 심화
모델 아키텍처 & 학습
- • HyperCLOVA/LaRva 계열 백본 + LoRA(PEFT) 어댑터 — 요약문→제목 생성 SFT
- • DPO 등장 이전 (2022년 말) — SFT + 자동 데이터 큐레이션만으로 preference 개선
- • Positive data만 남겨 재학습하는 SFT iteration 구조 설계
Multi-Criteria 필터링 파이프라인
- • 개조식 어미 검사
- • 어절 개수 2~6개 범위 필터
- • ROUGE-1 precision >= 0.75
- • RoBERTa-HyperUNICON 기반 semantic similarity >= 0.9
데이터 규모 & 반복 실험
- • Train positive data 1,904건→2,455건 (+29%)
- • 전 항목 오류율 개선 — 개조식 -48%, 어절 수 -32%, ROUGE -33%, semantic -12%
- • 후속 실험 — coverage 95.98%, valid 개조식 오류 12건→1건 (-92%)
담당 업무
HyperCLOVA/LaRva 계열 백본을 LoRA(PEFT) 튜닝으로 노트 제목 생성 모델 학습
Weak labeling 품질 분석 및 positive filtering 규칙 설계
개조식 어미, 어절 개수, ROUGE-1 precision, semantic similarity 기준의 multi-criteria 데이터 필터링 파이프라인 구축
RoBERTa-HyperUNICON 기반 LaRva sentence encoder 활용 semantic similarity 계산
Streamlit 기반 annotation/분석 도구 개발 — weak label 품질 분포와 필터 결과 시각화
Demo API 구축 — 뉴스 기사, 강의계획서, 영어/일본어 등 OOD 입력 범용성 검증
Positive data만 남겨 재학습하는 SFT iteration 구조 설계 및 반복 실험
이후 커리어와의 연결
DPO 없이 SFT + 자동 큐레이션으로 preference 개선
DPO가 없던 시기에 데이터 품질만으로 모델 선호도를 조정한 경험 → BHSN에서 법률 도메인 SFT/DPO 데이터 파이프라인 설계의 기반
평가 지표 설계
BHSN에서 20+ 법률 AI 평가 메트릭과 LLM-as-a-Judge 프레임워크 설계
LoRA 튜닝 실무
BHSN에서 Qwen2.5-14B 기반 5종 task-specific 어댑터 학습, predibase/lorax OSS 기여
Applied NLP delivery
모델 학습 → 데이터 필터링 → 평가 도구 → demo API 연결 — 이후 법률 AI end-to-end 개발의 원형